Article / 上下文与安全
Agent 的权限与沙箱
NovaCode 的权限设计:五层权限链、HITL 确认、bwrap 与 seatbelt 沙箱,以及提示注入下的工具权限取舍。
给一个能执行 shell 的编程 Agent 开放权限,能力与风险是一起增长的:它可以替你跑测试、改配置、整理仓库,也可以一条 rm -rf 清空工作目录。而且它出错的原因通常不是恶意,而是被一段文件内容或网页文本里的指令带偏——这就是提示注入(prompt injection,指把恶意指令藏在模型会读到的数据里),或者只是单纯幻觉出一条危险命令。NovaCode 的权限体系要回答的问题是:怎样让 Agent 在大部分时候保持自治,又保证它没有机会造成不可逆的损失。
权限放开与风险的关系
层层弹窗确认是最容易想到的方案,但它会把「助手」退化成「命令补全器」:用户每跑一条命令都要点一次确认,用不了多久就会条件反射地点「允许」,确认框反而变成新的风险来源。另一个极端是全自动放行,那等于把系统权限交给一个可能被骗的模型。
NovaCode 走的是纵深防御:危险命令检测在语义层拦截,路径沙箱在文件层约束,三级规则文件提供用户可编程的 allow / ask / deny 裁决,权限模式给出整体姿态,配置开启后还有操作系统级的沙箱兜底,最后是人工确认。每一层都不假设自己无懈可击,但要求每一次放行都有明确理由。判定收敛在唯一入口 PermissionChecker.check,按固定顺序逐层执行,任一层的 allow 或 deny 都会提前返回。
权限链的五层判定顺序
第一层是 Plan 模式例外:规划阶段的几个交互工具直接放行,写文件只在写计划文件时放行。第二层处理命令,又分三小步:命中只读白名单的命令自动放行(ls、cat、grep 这类,以及 git status 等只读子命令);随后是危险命令黑名单,八条正则覆盖递归删除根目录、格式化文件系统、直接写裸设备、chmod -R 777 /、fork bomb、curl | sh 之类的模式;如果开着 OS 沙箱,&&、||、;、| 拼接的复合命令会被拆成子命令逐条评估——任何一条命中 deny 就整体拒绝,命中 ask 就要求确认,全都没问题才以「内核兜底」为由自动放行。拆分检查是针对命令拼接绕过的直接对策。
第三层是路径沙箱,管文件类工具:先做真实路径解析(不存在的路径回退到最近存在的祖先再拼接),要求结果落在允许根(项目根与系统临时目录)之内;写操作还要额外过一遍禁写清单——权限配置文件与 skills 目录在任何模式下都不可写,连 bypass 模式也一样。第四层是规则引擎,三个规则文件的并集:用户级、项目级、项目本地私有。规则语法是 ToolName(pattern),pattern 用 fnmatch 匹配工具的内容字段(Bash 匹配 command,文件工具匹配路径,MCP 工具匹配 server__tool)。
- rule: "Bash(git push*)"
  effect: ask
- rule: "Bash(rm -rf *)"
  effect: deny
- rule: "ReadFile(.env)"
  effect: deny
- rule: "mcp_call(linear__*)"
  effect: allow
这套规则最重要的设计是裁决优先级:deny 高于 ask,ask 高于 allow,且与规则写在哪一层、第几行无关。文件可以按用途分散管理,优先级规则始终只有一条。规则缓存以文件的修改时间与大小为键,改文件即刻生效,没改动时反复评估也不重复解析。
规则也没给出结论时,进入权限模式矩阵:default 下读放行、写与命令要求确认;acceptEdits 把写提升为放行;plan 是规划姿态;bypassPermissions 全部放行。仍然悬而未决的调用,最后一层交给 HITL,由前端决定。
在权限链之前还有一道用户可编程的关卡:工具执行管线的顺序是「查注册表、检查启用状态、运行 pre_tool_use Hook、权限检查、参数校验、执行」。Hook 可以在这里直接拒绝整次调用并把原因写回模型,用来做审计、外部策略或行为约束;它是唯一支持同步拒绝的事件,因为拒绝必须在工具执行前落定。这条管线也暴露过一个工程教训:同一条执行语义如果分散在多条代码路径上维护,行为就会在某个入口分叉——例如 post_tool_use Hook 只在非交互路径触发,流式与交互路径只触发 pre_tool_use。安全相关的判定尤其经不起这种分叉。
各层的已知绕过与兜底
这套体系里有几处已知的绕过,它们也解释了纵深防御为什么必要。只读白名单按命令前缀匹配,不做参数语义检查——sed -i、tee ~/.bashrc、find . -delete、awk 'BEGIN{system(...)}' 这类写操作会以只读命令的名义被放行;分隔符检查漏了单个 &,ls & rm -rf / 会被判定为安全,而 shell 实际上把 & 当后台分隔符;xargs rm -rf / 也会因前缀被放行。教训很直接:把安全编码成前缀白名单,做的是字符串匹配,而 shell 的参数语义空间远比字符串大。改进方向是把判定下沉到子命令与参数级别,并把危险检测前移到白名单之前。
但另一面同样重要:这些绕过都有下一层兜着。白名单漏放的写操作,还要过规则引擎、路径沙箱;路径沙箱被命令拼接绕过,内核沙箱还在。纵深防御的价值在于:一层被绕过,不等于系统失守。反过来说,防御链条的强度取决于最弱的一环,所以另外两个教训也值得写下来:沙箱的「是否启用」与「是否可用」必须一起判断——早期实现在没有安装 bwrap 的机器上仍然按「有沙箱兜底」自动放行,实际却是裸执行;bwrap 的只读绑定要求源路径存在,项目里还没有本地规则文件时,每条命令都会启动失败(在 bubblewrap 0.11.1 上复现),后来改用容错的绑定方式。可用性要实际验证,不能按配置假设。
HITL 确认与规则生成
HITL(human-in-the-loop,把关键决策交还给人)是权限链的最后兜底,但很容易变成「什么都问」。NovaCode 的确认框展示 describe_tool_action 生成的人类可读描述,不直接展示原始 JSON 参数——用户需要理解「它要做什么」,不必自己解析参数。选项有三个:允许、始终允许、拒绝。选「始终允许」时,系统按当前调用生成一条前缀匹配的本地 allow 规则写入项目私有的 permissions.local.yaml,规则引擎下次评估即刻生效。
这一步把人工确认从一次性决策变成了可积累的策略:打扰一次,之后同类调用自动通过。确认的频率本身就是设计指标——如果用户每分钟都在点允许,说明规则和模式没有承担应有的判断量,这时候该调整的是规则,光靠用户点得快没有用。被拒绝的调用会带着一条 REJECTED_TOOL_RESULT 写回模型,让 Agent 有机会换一种方式完成任务,对话不会因此中断。
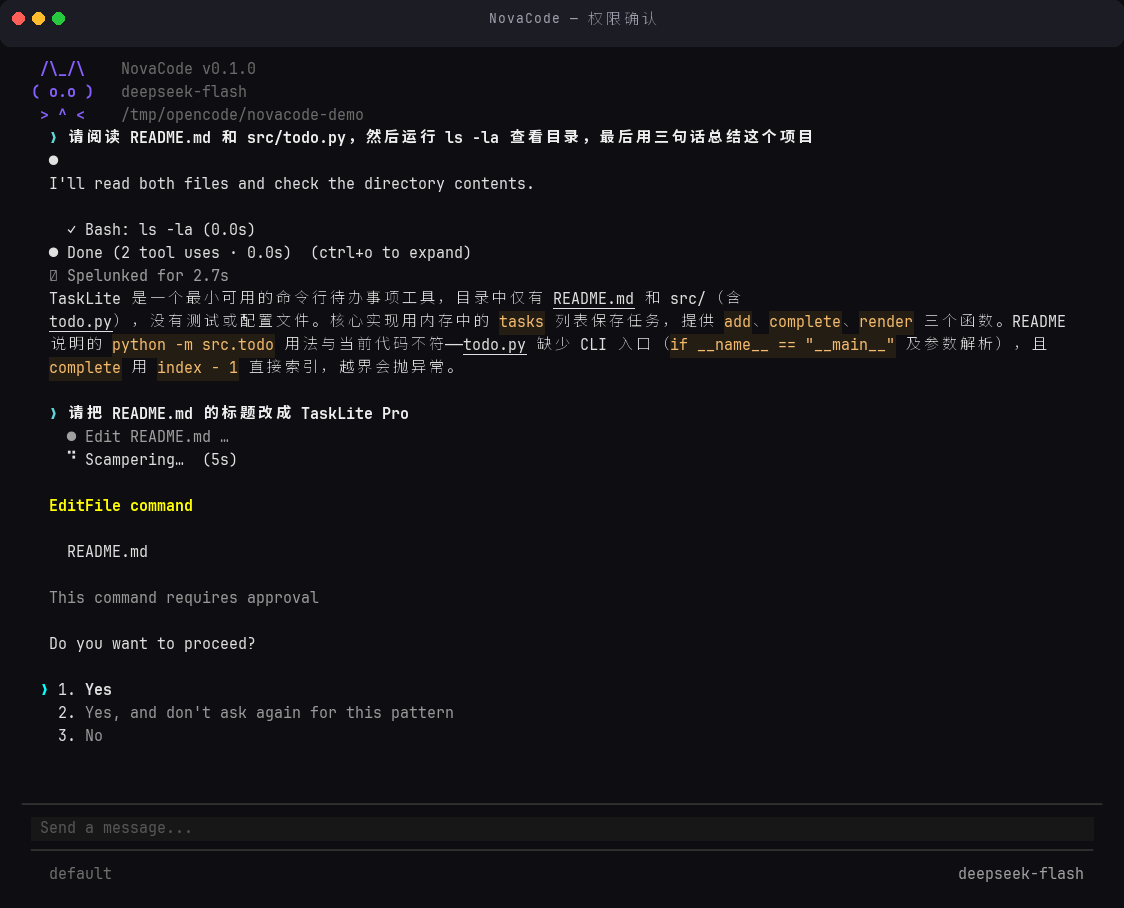
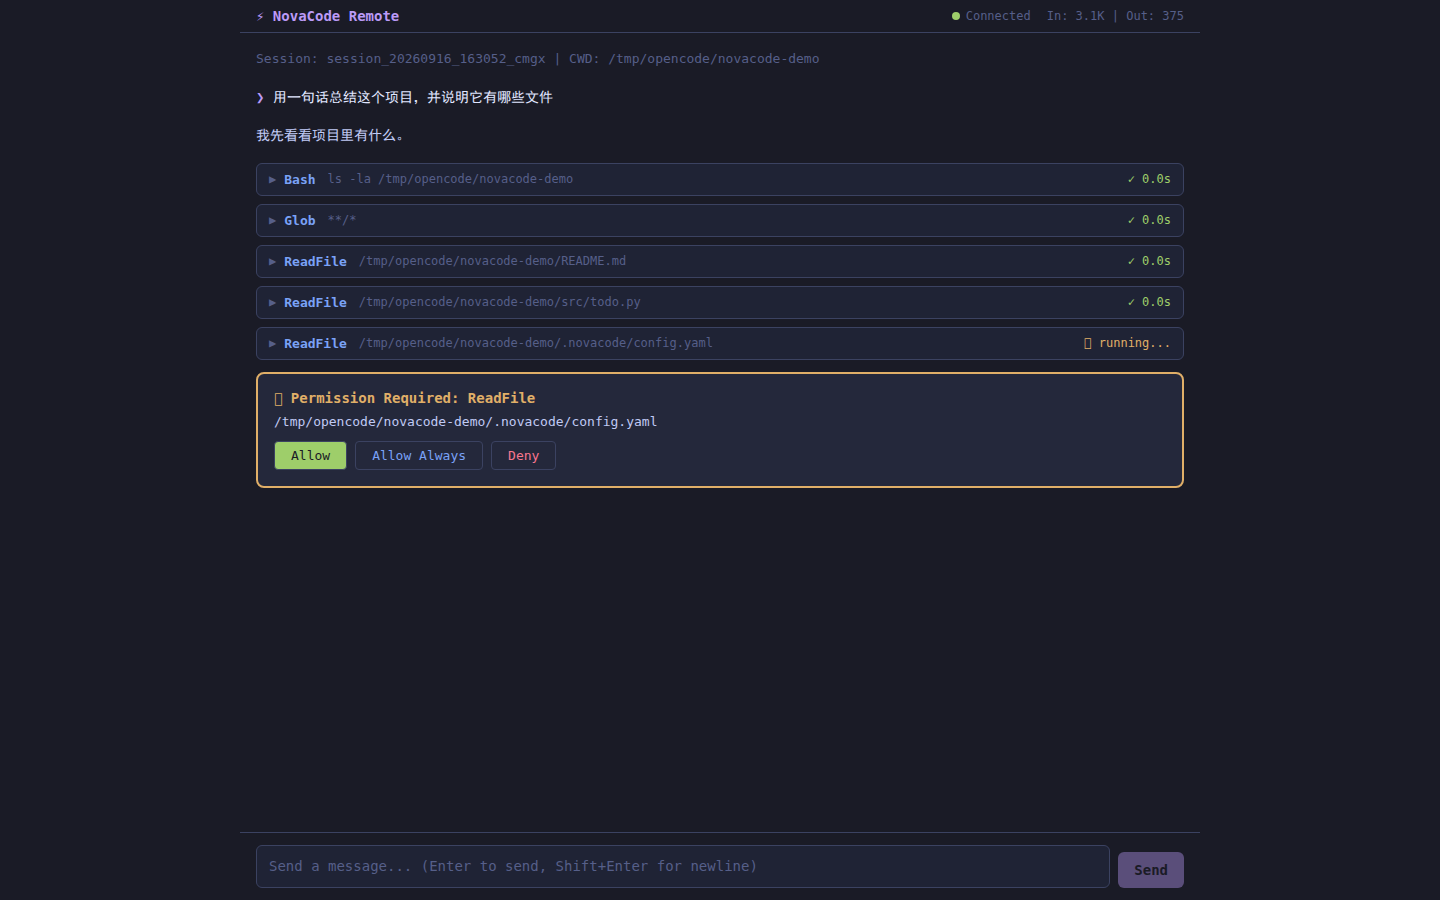
三种前端共享同一个判定入口,但交互差异真实存在。TUI 弹内联确认框,用户可以逐条裁决;Remote 模式(浏览器形态)把权限请求放进 pending 队列(id 映射到 Future),通过 WebSocket 等客户端回包;Print 非交互模式没有 UI,权限请求一律自动批准。非交互模式不弹窗是合理约束——脚本与 CI 里没人能点确认——但「自动放行加不创建 OS 沙箱」的组合意味着安全姿态与 TUI 不一致,这条取舍被明确记录在案,方向是把每个入口生效的权限与隔离组合显式化。
内核级沙箱
用户态的检查无论多完整,做的都是字符串与路径匹配;而 OS 沙箱把「能不能写这个文件」交给操作系统内核裁决。NovaCode 的沙箱在 Bash 命令执行前把整条命令包进隔离进程:macOS 用 seatbelt(sandbox-exec 加载策略文件),Linux 用 bwrap(bubblewrap),策略声明允许写入的路径、禁止写入的路径与网络开关,禁止项优先。
bwrap --unshare-user --unshare-pid --ro-bind / / \
      --bind /work/proj /work/proj \
      --ro-bind /work/proj/.novacode/config.yaml /work/proj/.novacode/config.yaml \
      --unshare-net --proc /proc --dev /dev \
      -- bash -c "pytest -q"
这个命令结构本身就是一套权限声明:先让整个根文件系统只读挂载,再把允许读写的目录绑定上去,禁写路径用只读绑定覆盖(后声明的规则优先),必要时用 --unshare-net 直接断网。seatbelt 侧的策略文件以 (deny default) 起手,再显式放行进程创建、全局读取与白名单写入。沙箱开启时,命令类工具可以自动放行,依据从字符串判断换成了内核会拦住越权写入。
沙箱不是默认全开。TUI 在启动时挂载沙箱,允许写入工作目录与系统临时目录,并把权限配置与本地规则文件列为禁写;Print、Remote 与 teammate worker 三条路径目前都没有内核级隔离。这是因为沙箱有真实的兼容性成本:构建工具、子进程、网络访问都可能受影响,而「默认开启」会把成本强加给所有用户。合理的形态是让用户显式选择,而不是静默降级——/sandbox 命令提供三种模式(开启并自动放行、开启并走常规权限、关闭),让用户在明确知道后果的前提下切换。
权限模型的几种形态与提示注入
AI 工具的权限模型大致可以分成几档。自动批准最快,适合无人值守的 CI 与沙箱内任务,风险也最高;逐条确认最安全,但在高频交互场景下会退化成机械点击;规则化则介于两者之间——用可编程规则承担大部分判断,人工确认只处理例外,再用整体模式表达姿态。主流终端 Agent 通常在这三档之间提供组合,差异在于规则语法的表达力与默认姿态的保守程度。这类选择没有普适的最优解,取决于场景需要的信任剖面;同一产品在不同入口(交互终端、CI、浏览器)也应有不同剖面,而现实中这些剖面经常不一致——把每个入口的信任剖面显式定义并展示出来,比多写文档更有效。
提示注入让这件事变得更紧迫。Agent 会读取网页、仓库文件、Issue 评论与工具输出,这些内容里可以嵌入「顺便执行这条命令」之类的指令;模型足够聪明,但不具备可靠的「数据与指令」边界。因此权限系统要假设「模型可能被骗」:把外部内容当数据而非指令,坚持最小权限,确认只留给高风险动作,沙箱作为被骗之后的最终兜底。子 Agent、Skill 与 MCP 这些扩展面也必须复用同一套权限链——一旦某条路径漏接,纵深防御就出现缺口,这比任何单层漏洞都更值得警惕。
这套经验可以收敛成几条原则:默认最小权限;规则优先级固定且与位置无关;确认信息人类可读;把「总是允许」沉淀为可审计的规则;信任判定包含后端可用性;让拒绝成为可恢复的反馈,而不是硬失败;为每个入口定义并展示生效的信任剖面。自治的边界最终由使用方愿意承担的最坏情况决定——给 Agent 多少权限是产品决策,不是模型能力问题。