Article / Agent 与编排
Agent 是怎么跑起来的
从 ReAct 循环到异步事件流,拆解 Agent 运行内核、流式工具执行与多协议模型客户端的归一化。
聊天机器人接收一段文本、返回一段文本;Agent 接收一句话后,会陆续读文件、跑命令、看结果、再决定下一步。差别不在模型本身,而在模型外面的那圈循环。ReAct 循环、事件流与流式工具执行是 Agent 运行骨架的三块内容,NovaCode 的真实实现会作为贯穿案例,把一次请求拆成可观察的事件。
Agent 与聊天机器人的区别
聊天机器人的工作模式是单轮的:输入一段文本,输出一段文本。它的上限由模型的知识边界决定,系统侧几乎不需要状态。
Agent 的核心是一个循环:模型推理当前状态,决定是否调用工具;宿主执行工具,把结果喂回去;模型继续推理,直到不再请求工具。这个「推理—行动—观察」的循环叫 ReAct(Reasoning and Acting,边推理边行动),能读代码、跑测试、根据报错改实现的编程助手,都是它的变体。循环的终止条件是「模型不再需要环境反馈」,输出写完并不代表循环结束。这一点改变了整个系统的形态:运行时长、调用次数、成本都由任务决定,调用方只负责发起和等待结果。
Function Calling(函数调用)是循环的入口机制,也是常被误解的一点:模型并不会真的执行任何函数。它在响应里输出结构化的工具调用块——工具名加参数——宿主程序负责校验、执行,再把结果作为新消息写回历史。NovaCode 把全部工具的 JSON Schema 交给模型,Anthropic 协议用 input_schema,OpenAI 系列用函数定义对象,工具注册表按协议输出两套 schema,模型看到的始终是同一批能力。工具定义的来源也统一:每个工具是一个类,参数模型用 pydantic 声明,schema 从类型自动生成,新增能力的成本被压到「写一个类加注册一行」。
Agent 循环还有一个近亲:先规划再执行。它把「拆步骤」与「做步骤」分开,计划可以在动手前被人审阅,适合步骤清晰、返工代价高的任务。NovaCode 用 Plan 模式承载这类场景:计划写进文件、每轮重新注入提示,批准后才退出计划模式——本质上仍是循环,只是插了一段需要确认的规划阶段。选择哪种形态,取决于任务的可预测程度:流程越固定,越适合用确定性代码或工作流引擎;环境反馈越重要,循环的价值越大。
循环能执行 shell 命令,这既提高了能力上限,也放大了破坏风险,所以工具体系与权限链总是配套出现:危险命令拦截、路径沙箱、规则引擎与人工确认共同决定哪些动作可以自动发生(见 权限与沙箱)。循环本身要解决的是另一个问题:每一轮按什么顺序做事,状态放在哪里,出错怎么恢复。
一次循环的步骤
NovaCode 的 Agent.run() 是一个异步生成器,每一轮迭代的步骤是固定的。轮次开始:触发 turn_start 钩子、消费团队邮箱、排空后台任务通知;提交 pre_send 钩子,注入本轮需要的 system-reminder;取工具 schema、做上下文压缩检查;然后才发请求并流式消费响应。流结束后分两条路:
- 模型没有请求工具,进入收尾轮:触发记忆提取、
turn_end钩子、文件快照,产出LoopComplete结束; - 模型请求了工具,就把执行结果写回历史,产出
TurnComplete进入下一轮。
这里有一个容易被忽略的工程细节:工具结果在写入历史之前就完成大小控制,此后不再修改。这样做的直接收益是 prompt cache(提示词缓存,服务端把请求的稳定前缀缓存下来,命中部分按更低费率计费)——历史一旦成型就不再改写,缓存前缀不会因后续修订而失效。输出中断也有专门的恢复路径:遇到 max_tokens 截断时,第一次只提升输出上限并要求模型从中断处续写,之后再触发最多三次恢复,恢复提示会要求把剩余工作拆成更小的片段。压缩、溢写与恢复这些上下文机制,决定了 Agent 能不能跑长任务(见 上下文工程)。
钩子与注入的顺序也有讲究:环境上下文与记忆注入发生在第一个事件产出之前,调用方拿到第一个事件时,上下文已经装配完成;压缩重写历史之后,环境与长期记忆会重新注入一次,因为压缩会清空它们的注入标记。前端因此不需要关心「上下文此刻是否完整」:事件到达时,状态已经就绪。
循环默认不限轮次,只有调用方显式设置上限才生效。这个默认值反映了 Agent 与聊天机器人的区别:跑多久由任务决定。也正因为运行可能很长,「压缩边界要持久化」「取消要有明确语义」这类需求会依次浮现——它们都是长任务倒逼出来的设计。
事件流的作用
上层与循环之间的接口只有一行:
async for event in agent.run(conversation):
    ...  # 按事件类型渲染或转发
事件是一组 dataclass 的联合:StreamText、ThinkingText、ToolUseEvent、ToolResultEvent、TurnComplete、LoopComplete、UsageEvent、PermissionRequest、CompactNotification。选择异步生成器而不是回调,是因为「持续产生、由消费方按自己的节奏处理」符合流式场景:生成器天然支持背压,消费方停止迭代就等于停止后续产出;回调则需要自己维护生命周期与取消语义,复杂得多。
事件粒度直接决定了前端可以呈现哪些信息:
StreamText映射为逐字打字效果,ThinkingText映射为可折叠的思考块;ToolUseEvent与ToolResultEvent映射为时间线上的工具卡片,可以展示参数、耗时与结果;UsageEvent累计 token 与缓存命中,前端据此展示成本;- 权限确认以一条携带
asyncio.Future的PermissionRequest事件下发:前端渲染确认框,用户选择后 resolve 这个 future,循环继续;选择「总是允许」会把规则写进本地文件,后续同类调用不再弹窗。
事件契约保持稳定:LoopComplete 之后不再有任何事件,字段扩展只做加法。Print 模式把事件映射成 NDJSON 后,脚本消费的是与 TUI 完全相同的语义——CI 里判断一次运行是否成功,不需要解析日志文本,直接看 result 行携带的工具调用列表与累计用量即可。
同一份契约支撑三种前端形态:Textual TUI 内联渲染,Print 模式把每个事件映射为一行 NDJSON(每行一个 JSON 对象)供脚本与 CI 消费,Remote 模式把事件转发到 WebSocket。前端是事件契约的消费方,核心循环不做前端分支:增加一种前端时不需要改动循环。
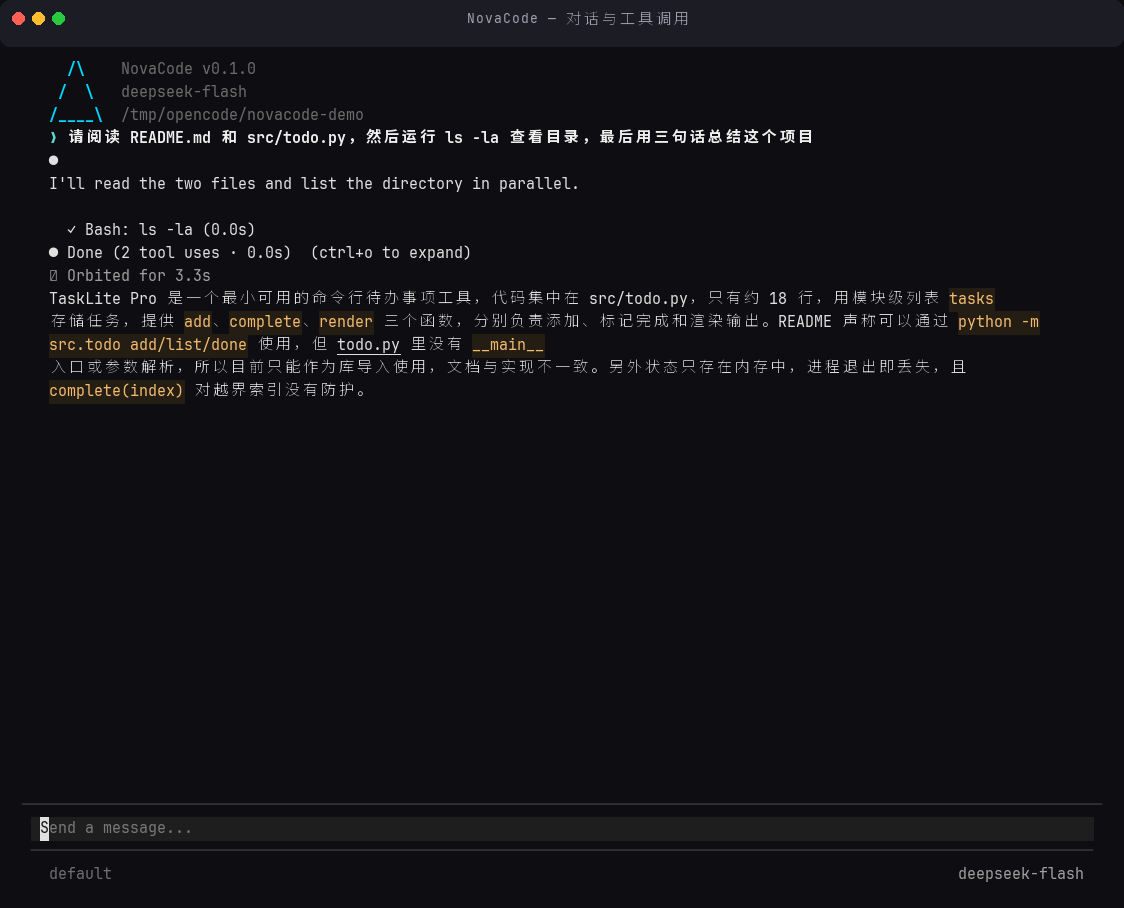
截图里一次 Bash 调用被渲染成可折叠的块,与最终回答挂在同一条时间线上:纯文本事件变成答案,工具事件变成过程记录。如果前端需要猜测循环内部的状态,说明事件流还缺少必要的事件。
流式期间的并发工具执行
传统做法是等模型把整条响应输出完,再解析工具调用、逐个执行。NovaCode 把两件事重叠起来:流式消费器每拿到一个完整的工具调用块,就立刻向主循环产出 ToolUseEvent;主循环马上做权限判定,然后分两类处理:需要人工确认的工具进入延迟列表,等流结束后串行执行;其余工具立即提交给 StreamingExecutor,模型还在输出后续内容时,工具已经在跑。
class StreamingExecutor:
    def submit(self, coro):
        task = asyncio.create_task(coro)
        self._tasks.append((self._order, task))
        self._order += 1

    async def collect_results(self):
        tasks = [t for _, t in sorted(self._tasks, key=lambda x: x[0])]
        return await asyncio.gather(*tasks, return_exceptions=True)
提交时编号、收集时按编号 gather,结果顺序与模型给出的调用顺序一致;单个任务抛异常会被包成错误结果,不会中断整个循环。这样做节省的是实际等待时间:一轮里模型输出三个工具调用的参数,第一个工具不必等第三个参数生成完就开始执行。
「确认类工具必须串行」由交互形式决定:对话框不能同时弹两个,需要用户注意力的操作也不适合并发竞争。只读工具之间没有这种冲突,并发是安全的。不过 NovaCode 当前对所有非交互工具一律并发提交,按「并发安全标记」分批执行的函数已经实现但尚未接入主路径,这是一笔明确记账的技术债;流式路径对同一次工具调用做两次权限检查、以及 run() 被取消后已提交的工具任务会继续完成,也是同一批已知取舍:取消生成器不会取消已经提交的工具任务。
人工确认的工具走另一条批处理链:流结束后,延迟列表里的调用按顺序逐个执行——确认框要等用户,不能并发,交互式提问更是要等最长五分钟的输入。两批结果最终汇入同一个聚合与定型流程,因此写进历史时,一轮工具调用的形态是一致的,只是执行时机不同。
结果收尾还有一道聚合预算:整批结果总字符数超过 50,000 时,从最长的开始溢写落盘、替换成预览,最后合成一条 tool results 消息写入历史。历史定型保证缓存前缀稳定,同轮多结果共享一条消息,预算按整批总量计算,避免一条巨型输出占满上下文。
三种模型协议的归一化
循环只处理一套流式事件,厂商协议差异全部由模型客户端吸收。NovaCode 支持三类:Anthropic 的 messages.stream、OpenAI 的 Responses API、以及兼容 Chat Completions 的 OpenAI-compatible 端点,vLLM、Ollama、Together 这类自托管与聚合服务都落在第三类。三种协议的流式事件形态完全不同,客户端把它们归一化成同一组 StreamEvent:TextDelta、ThinkingDelta、ToolCallStart、ToolCallDelta、ToolCallComplete、StreamEnd。
归一化里最容易出错的是「字段看起来一样、口径却不同」的部分。思考内容上,Anthropic 有独立的 thinking 块,部分兼容端点用非标准的 reasoning_content 返回思考,客户端要把它识别成同一语义。用量上,Anthropic 的 input_tokens 不含缓存部分,OpenAI 系列要减去缓存命中,归一化后的 StreamEnd 统一保证 input + cache_read 可加;个别端点把真实用量放在流末尾的消息里,客户端也要能降级取用。上下文窗口按四层回退解析:配置显式值、Anthropic 的模型列表接口、内置的模型名映射表、最后是保守默认值。
思考预算的处理也做过适配:较新的 Claude 模型可以自己决定思考多少,客户端就传零预算让模型自适应;较老的模型则用显式预算,取输出上限与一个下限之间的较大值。这类分支如果散落在业务代码里会难以维护,集中到客户端之后,循环只需要关心事件与用量。
Anthropic 路径还会在三段最长稳定前缀上打缓存断点:system 块、工具数组末尾、最后一条用户消息的尾部。断点之后的字节天然稳定,这反过来约束了上层的设计——工具 schema 不能被随意改写,工具结果必须进历史前定型,MCP 工具的加载策略也要尽量少动前缀。成本模型因此成为架构约束的一部分,而不是运行期的调优项。
这些细节对应一个架构判断:模型协议是可替换的,事件契约是长期稳定的。把厂商差异、计费口径、窗口大小都收进适配层,循环与前端就不需要为换模型改代码。
循环与编排框架的关系
手写 ReAct 循环换来的是对事件粒度、权限交互与扩展面的完全控制,代价是多条工具执行路径的重复实现要自己维护。CitedRAG 选择了另一条路:把多 Agent 流程交给 LangGraph,用状态图换可预测的编排与断点恢复。两种选择没有绝对优劣,只有约束不同。